
前期准备
- CPU:XEON E2286M 8核心16线程 属于 Intel 9代 移动工作站系列
- 内存 SKhynix 16G 3200MT/s
- 计算卡:重头戏 NVIDIA V100 16G PCIE
- 系统 Ubuntu
安装推理框架 Ollama 并且安装驱动
安装Ollama
curl -fsSL https://ollama.com/install.sh | sh 1
下载并导入 gguf 模型文件
GGUF 是一种二进制格式,旨在优化模型的快速加载和保存,使其在推理方面非常高效。GGUF 设计用于与 GGML 及其他执行器配合使用。GGUF 由 @ggerganov 开发,他同时也是广受欢迎的 C/C++ LLM 推理框架 llama.cpp 的开发者。原本在 PyTorch 等框架中开发的模型可以转换为 GGUF 格式,以便在这些引擎中使用。
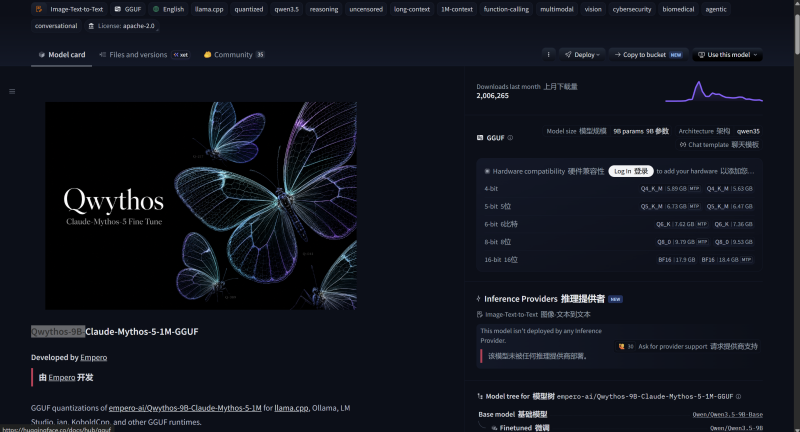
https://huggingface.co/ 是一个免费分享与下载模型和数据集的网站,类似与 Github
例如作者使用的模型是 Qwythos-9B 。可以根据硬件来选择量化模型,例如我下载的是 BF16 精度的模型
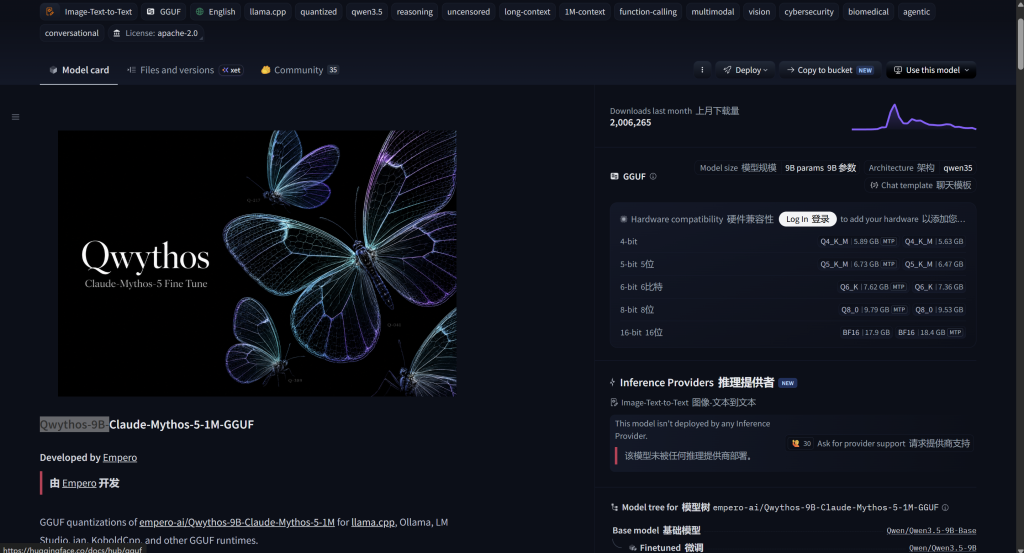
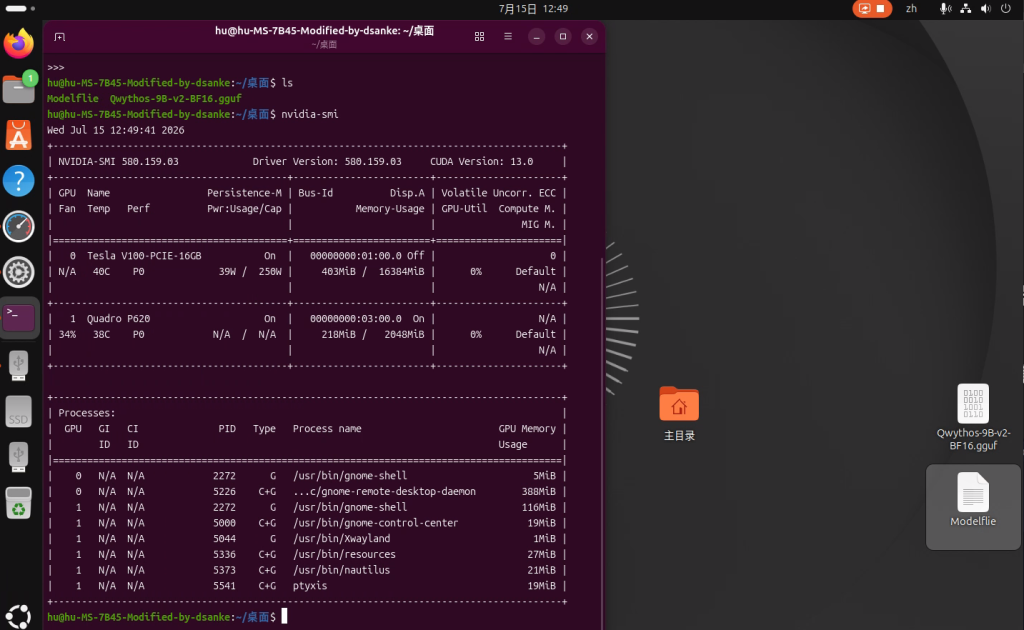
下载好后如图是一个后缀为 gguf 的文件,在此目录下新建名为 Modelfile 的文件,填入
FROM ./path/to/file.gguf 2
然后在此目录下新建终端执行
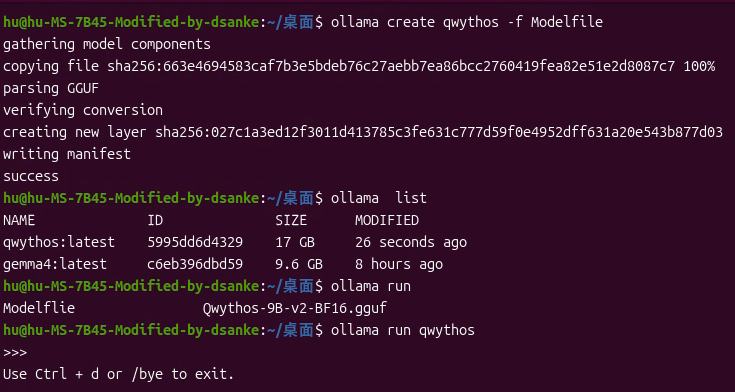
ollama create my_model -f Modelfile
验证与运行大模型
ollama list查看当前存在的模型ollama run my_model运行模型ollama ps查看当前正在运行的模型
接入 OpenClaw
ollama
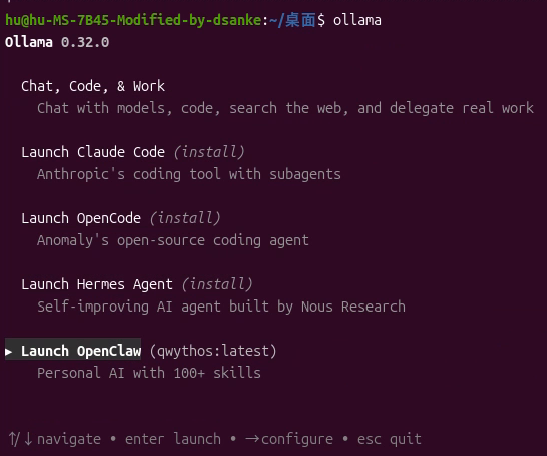
Launch OpenClaw 他会自动帮你安装好 OpenClaw 并且导入
参考链接
https://docs.ollama.com/ Ollama 官方文档
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
暂无评论内容